




Brave Searchは、GoogleやBingから結果を借りず、自社でゼロから構築したインデックス上で動作する検索エンジンです。ただしSEO担当者にとっての重要性は別のところにあります。AnthropicはBrave SearchをClaudeのウェブ検索提供元として挙げているのです。つまりClaudeがウェブを調べて回答する際、その結果はBraveのインデックスを経由します。Brave Searchへの対応は、自社サイトがClaudeに引用される最も直接的な道筋だといえます。
この記事では、Brave Searchの仕組み、Braveへの対応を他の検索エンジンと決定的に分ける技術的な特徴、そしてそこから導かれる実務をご説明します。
Brave Searchとは
Brave SearchはBrave Softwareが提供する検索エンジンで、2021年10月19日以降にBraveブラウザをダウンロードした利用者には既定の検索エンジンとして設定されています。多くの代替検索エンジンと異なるのは、Braveがゼロから構築した自社インデックス上で動作している点です。いまなお多くのサービスがGoogleやBingのAPIから結果を取得しているのとは対照的です。
このインデックスは2つの経路から拡充されています。Brave自身のクローラーと、Web Discovery Projectです。後者はBraveブラウザの利用者が匿名化された閲覧データを任意で提供する仕組みで、Braveは既定では無効であり利用者が自ら有効にする必要があると明記しています。
Brave SearchがClaudeと直接つながる理由
Trust Centerで公開されている委託先一覧で、AnthropicはBrave Searchを目的「Web Search」として記載し、適用範囲を全製品としています。同じ目的にはTurboPufferも挙げられており、こちらはClaude for Governmentを除く全製品が対象です。
2件目は注目に値します。AI対応に関する解説の多くはBraveだけに触れて終わっているためです。実際にはClaudeは単一の提供元から結果を引いているわけではないため、Brave Searchに掲載されることは引用される可能性を高めますが、保証するものではありません。
TOSの診断ツールがBrave関連の項目を「TOSが外部から確認できない項目」に分類しているのもこのためです。あるウェブサイトがBraveのインデックスに入っているかを調べられる公開APIは存在しません。
最も重要な特徴:Braveは専用のユーザーエージェントを名乗らない
ここがSEO担当者の誤りやすい点です。Braveのボットは意図的に専用のユーザーエージェントを名乗りません。Braveはサイト運営者向けの文書でその理由を説明しています。Googleにのみクロールを許可しているサイトから差別的に扱われるのを避けるためです。
そこからBrave自身が公表している重要な原則が導かれます。Googlebotがクロールできないドメインやページは、Brave Searchのボットもクロールしません。
実務上の帰結は3点です。
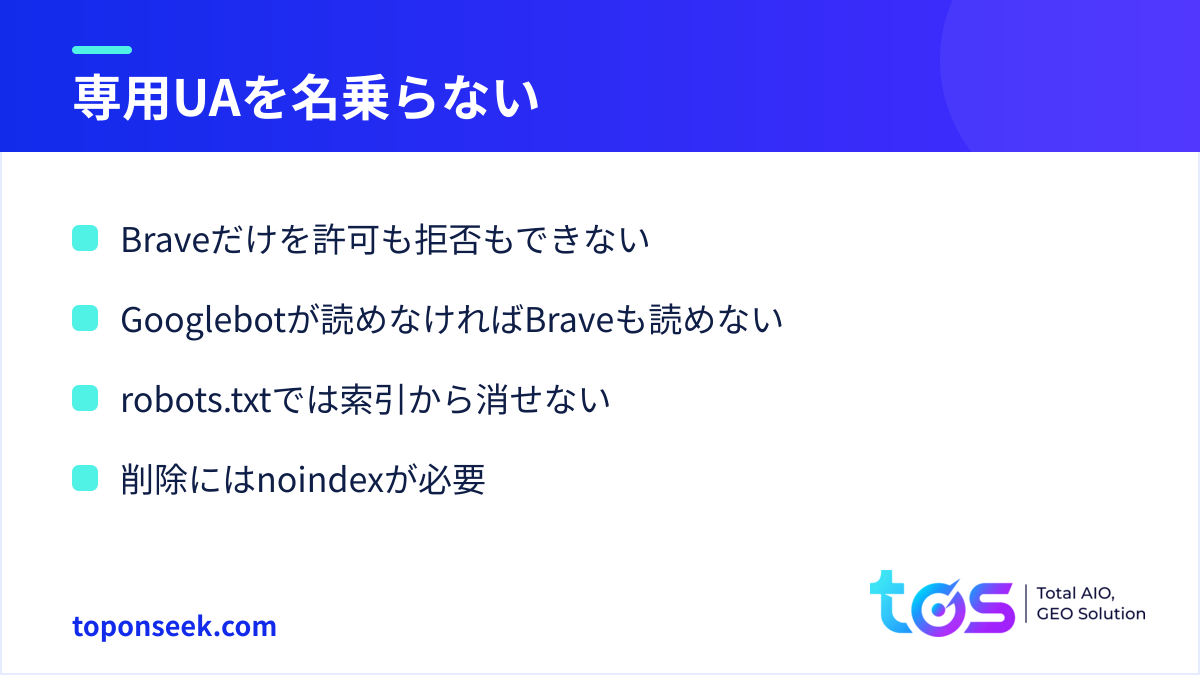
- robots.txtに
User-agent: Braveと書き加えても意味がありません。その名前で照合される対象が存在しないためです。 - Braveに読ませたいなら、やるべきことはGooglebotが読める状態にすることです。Googlebotを拒否すればBraveも拒否され、結果としてClaudeの入口も塞がります。
- Googleを許可したままBraveだけを拒否することはできません。両者は連動しています。
Brave Searchからページを削除する方法
Braveは文書でrobots.txtはページのインデックス登録を防ぐためのものではないと明言しています。正しい方法は該当ページに noindex を設定することで、その後Braveがページを再取得して変更を反映します。search.brave.com/submit-url からURLを送信すると反映を早められます。
削除済みのページが結果に残っている場合、Braveは not-found@brave.com で報告を受け付けています。個人情報に関わる場合は、別途Right To Be Forgottenの手続きに従ってください。
Brave Search対応のチェックリスト
- robots.txtがGooglebotを拒否していないか確認してください。Braveのボットの権限はGooglebotと同一になるため、これが最も効果の大きい作業です。
User-agent: *のグループや、重要なディレクトリに対するDisallow: /も併せてご確認ください。 - 誤って付いた noindex を洗い出してください。
noindexのあるページはGoogleから消えるのと同様にBraveからも消え、Claudeに引用される機会も失われます。 - 重要な新規ページはURLを送信してください。Braveには本格的なサイト管理ツールがないため、URL送信フォームは数少ない能動的な手段です。
- XMLサイトマップを整理し、最新に保ってください。名乗らないボットを含め、すべてのクローラーにとって有益です。
- 抽出しやすい本文を書いてください。1ページ1テーマ、意味の明確なH2、冒頭で質問に直接答える記述、列挙は箇条書きや表に。AIアシスタントは短く単独で意味が通る箇所を引用します。
- 構造化データを追加してください。sameAsを伴うOrganization、ArticleまたはBlogPosting、FAQPage、BreadcrumbListがあると、機械が実体と文脈を読み取りやすくなります。
- E-E-A-Tのシグナルを強化してください。プロフィールページを持つ実名の著者、更新日、信頼できる出典への言及です。
この7項目は、TOSが用いているGEOの対応方針とほぼ重なります。当然ともいえます。Brave Searchは専用の技術対応を求めているわけではなく、技術的に整っていて内容が明快なサイトを評価しているだけだからです。
自分で確認する方法
- search.brave.com でブランド名を検索し、続けて主要なサービス関連のキーワードを3〜5件試してください。Googleの結果と比べると差が見えます。
- 公開したばかりの記事から特徴的な一文を引用符で囲んで検索し、Braveがそのページを取得済みか確認してください。
- ウェブ検索を有効にしたClaudeに、自社が答えるべき質問を投げ、引用元を確認してください。
確認できないこと
TOSは過度な約束を避けるため、限界も明示します。Braveはインデックスの規模、検索クエリ数、自社インデックス由来の結果の比率をいずれも公表していません。サイト運営者がBraveでの表示状況を確認できるツールもありません。さらにClaudeには第2の検索提供元があるため、Braveのインデックスに入っていればClaudeに必ず引用される、と言える人はいません。
よくある質問
robots.txtにBraveのボット専用の記述は必要ですか?
必要ありませんし、書いても効果はありません。Braveのボットは専用のユーザーエージェントを名乗らないため、その名前を指定した行には一致しないからです。アクセスを決めるのは、robots.txtがGooglebotに与えている権限です。
GPTBotやClaudeBotを拒否するとBrave Searchから消えますか?
消えません。これらはOpenAIとAnthropicの学習用クローラーであり、Braveのクローラーとはまったく別のものです。拒否してもBraveのインデックスへの掲載には影響しません。
Brave SearchにGoogle Search Consoleのような管理ツールはありますか?
現時点ではありません。BraveはURL送信フォームと、存在しなくなったページを報告するためのメールアドレスを用意していますが、表示回数や順位を示す管理画面はありません。
Brave Searchへの対応はGoogleの順位に悪影響を与えますか?
与えません。Brave専用の手法が存在しないためです。チェックリストの内容はいずれもGoogleが評価する事項と同じで、ボットが読めること、本文の構造が明確であること、構造化データが揃っていること、E-E-A-Tのシグナルが強いことです。
自社サイトがこれらの条件をどこまで満たしているかは、TOSの無料AI Visibility診断でご確認いただけます。6つの技術項目を採点し、Claudeを含むAIプラットフォームごとの優先順位をご提案します。
 TOS · Search AI Agency
SEO・AIの最新情報を毎日お届け
実務に役立つ内容だけを厳選してお届けします。スパムは送りません。